Simuler les Droplets SSD à 5 $ de DigitalOcean
En 2014, DigitalOcean connaissait une hypercroissance. Avec l'hypercroissance venaient évidemment des problèmes de passage à l'échelle rapide et des crises de croissance. Avec de nouveaux paradigmes apparaissent de nouveaux comportements d'utilisateurs. En l'occurrence, les gens adoraient les Droplets (le nom que DigitalOcean donnait à son produit de machines virtuelles) et en créaient de nouveaux et les supprimaient et les recréaient et ainsi de suite. Une croissance globale, avec une bonne partie de la population de Droplets à courte durée de vie.
Un sandwich Footlong de Subway pour 5 $, ou un Droplet SSD
Quand DigitalOcean a trouvé son product-market fit, les fondateurs Ben et Moisey avaient imaginé un élément différenciateur accrocheur. À l'époque, le cloud était encore un domaine naissant, en plein essor, et en plus d'un tas de fournisseurs de VPS indifférenciés, AWS offrait des micro-VM gratuites. Linode était un VPS traditionnel qui proposait des VM clic-clic-clic avec des disques rotatifs.
DigitalOcean avait l'hubris de vouloir ne plus être un fournisseur de VPS et de devenir plutôt un pure player du cloud, avec AWS dans sa ligne de mire, en plein délire. Pour y arriver, le gimmick, c'était qu'on vendrait des Droplets (VM) de 512 Mo avec 20 Go de SSD local, pour 5 $ par mois. À l'époque, personne d'autre ne faisait ça. Les micro-VM gratuites d'AWS avaient du stockage en réseau qui était lent à mourir, et les autres fournisseurs de VPS avaient des disques rotatifs. DigitalOcean, c'était 100 % flash, et pour seulement le prix d'un sandwich Footlong de Subway (Ben adorait tout simplement parler des sandwichs Footlong).
Hé mec, tu peux avoir une VM avec des SSD pour le prix d'un Footlong Subway ! C'est pas génial, ça ! - probablement quelque chose qu'a dit Ben Uretsky (cofondateur et alors CEO de DigitalOcean)
Oui Ben, c'est génial. Et c'était assez génial pour que DigitalOcean soit aujourd'hui un fournisseur cloud valant plusieurs milliards de dollars.
Plein de petits Droplets
Alors je suis arrivé, et nous avions toute cette demande pour nos Droplets SSD à 5 $ complètement fous. Ces Droplets devaient être placés sur des nœuds hyperviseurs. Ces nœuds étaient de gros serveurs bien gras avec juste un tas de SSD coûteux dedans : pas la moindre rouille qui tourne. Et on entassait un tas de petites VM agaçantes de 512 Mo sur ces énormes hyperviseurs, et chacune de ces VM voulait faire tourner les mêmes quelques images Ubuntu ou Debian ou que sais-je comme image Linux, puis une traîne d'autres images.
Ces images disque étaient des blobs assez gros (de mémoire, à la louche : p50 à 1 Gio, p90 à 5 Gio) et devaient venir de quelque part, et ce n'étaient pas les SSD de l'hyperviseur, puisque c'était précisément ce qu'on vendait. Les images disque étaient stockées sur un parc de serveurs de stockage et chaque fois qu'un client nous commandait un Droplet, on lui trouvait un hyperviseur, on disait au code de l'hyperviseur « récupère cette image de N Gio et exécute-la ». Et puis, comme ces Droplets à 5 $ se vendaient comme des petits pains, on avait un tas de gens qui essayaient tous de récupérer toutes ces images sur le parc d'hyperviseurs en même temps, pompant tout le réseau, ce qui faisait que personne n'avait de sandwich. Tout cela se faisait au départ via NFS, qui n'avait aucune notion de ce qu'est une image disque ni de la façon de la traiter comme une image disque.
Accueillir la douleur, devenir la douleur
Ce n'était pas brillant. Nous voulions être brillants. Quelques copains et moi (Nick Van Wiggeren, Mac Browning, Justin Hines, Matt Layher) nous sommes lancés dans une mission : quitter NFS et créer un service de gestion d'images. Ce truc allait gérer tout le cycle de vie des images disque et « savoir » ce qu'était une image disque, et les diverses choses dont nous avions besoin de la part d'un truc qui connaît et sert des images disque. Beaucoup de choses intéressantes sont sorties de ce projet dans son ensemble, notamment le premier « service Go HTTP/JSON moderne » que DigitalOcean ait construit en dehors de son monolithe Perl initial. Et à la fin de ce projet se trouvait un problème particulier dont je veux parler aujourd'hui. Et j'y ai fait allusion plus haut : comment nos clients avaient pris goût à enchaîner les Droplets à un rythme effréné.
Avant, chez Shopify, Tobi avait accueilli le BFCM et les ventes flash comme des comportements d'utilisateurs pathologiques qu'il fallait célébrer et rendre normaux et rapides. Tout juste arrivé de là-bas chez DigitalOcean, je voulais la même chose. Je voulais que les gens puissent enchaîner les Droplets et que nous gérions ça bien grâce à notre jugeote et nos cerveaux. Je voulais qu'on soit bons là-dedans. Ravir nos clients avec l'expérience de création de Droplets la plus rapide que nous puissions offrir, à grande échelle, et célébrer ces ventes flash de Droplets comme un comportement génial que nous accélérerions et rendrions rapide.
Alors comment faire démarrer ces Droplets le plus vite possible, quand 99 % du temps de démarrage était passé à télécharger de grosses images disque depuis un petit ensemble de nœuds de stockage ?
Mettre en cache quand on ne veut pas
La solution naïve et la plus simple, c'est de pré-positionner les images disque sur les hyperviseurs. Sauf que nous ne savions pas exactement quelles images il faudrait, ni où, et la demande était assez variée pour qu'à part la dernière Ubuntu, ce qui viendrait ensuite ne soit pas évident sans un bidouillage constant et des « je pense que les gens vont vouloir cette image ensuite » réactifs de la part d'ingénieurs qui positionneraient manuellement des images disque sur certains hyperviseurs. Ça demande beaucoup de main-d'œuvre et c'est un peu bricolé. Et en plus, toutes ces images disque pré-positionnées utilisent de l'espace sur les SSD des hyperviseurs que nous voulons vendre, pas utiliser comme stockage d'images disque...
Puis l'autre solution évidente suivante, c'est de mettre les images en cache à mesure qu'elles sont demandées. Alors il nous faut... réserver une certaine quantité d'espace disque de l'hyperviseur pour le cache, ce qui n'est pas non plus ce que nous voulons faire avec ces SSD : nous voulons les vendre 5 $ par mois.
De plus, ces Droplets à 5 $ étaient la poule aux œufs d'or à l'époque, et les gens avaient une sacrée trouille de tout faire foirer et de casser les Droplets. Par-dessus le marché, le code du monolithe géant qui tournait sur l'hyperviseur était un fouillis de Perl auquel absolument personne ne voulait toucher. En gros, faire quoi que ce soit sur ces hyperviseurs faisait grimper le taux de cortisol de quiconque en avait la charge. Et il nous fallait l'adhésion de l'équipe qui gérait cette base de code.
Donc certains de nos degrés de liberté étaient contraints :
- Nous ne voulions pas gaspiller d'espace SSD en pré-positionnement
- Nous ne voulions pas gaspiller d'espace SSD en cache
- Nous avions peur de toucher aux hyperviseurs en général
Degré de liberté caché
Mais voici une chose qui n'était pas évidente.
- Au bout du compte, nous ne voulions pas réserver d'espace disque SSD pour le cache parce que nous voulions le vendre.
- Nous avions le plus d'espace disque disponible pour le cache quand l'hyperviseur n'avait aucun Droplet (0 % vendu).
- Nous avions le moins d'espace disque disponible pour le cache quand l'hyperviseur commençait à être plein.
- Nous pouvions nous permettre de gaspiller de l'espace disque quand l'hyperviseur était invendu.
- Nous ne pouvions pas nous permettre de gaspiller de l'espace disque quand l'hyperviseur devenait complet.
- Nous avions une certaine légitimité institutionnelle à toucher à ce code, puisque nous faisions passer la pile de l'hyperviseur de NFS à HTTP et introduisions un nouveau chemin.
Donc en gros, la mise en cache, ça allait tant qu'on cédait la place à mesure que l'hyperviseur se remplissait. Le degré de liberté : utiliser l'espace disque pour le cache de façon inversement proportionnelle à l'usage du disque par les Droplets.
Blobcache : un cache autorétrécissant
J'ai donc conçu blobcache, le cache autorétrécissant. Ce cache utiliserait une quantité fixe des SSD de l'hyperviseur et surveillerait une marge tampon pour toujours garder un espace libre d'une certaine taille de marge tampon.
max_cache_space := 4 GiB
buffer_space := 2 GiB
min_free_space := 10 GiB
Il regardait l'espace libre du disque et déterminait combien de cache il avait le droit de garder. Tout l'espace libre restant au-dessus de min_free_space + buffer_space était bon à prendre, jusqu'à max_cache_space :
headroom := disk_free() - min_free_space - buffer_space
allowed := clamp(cache_space + headroom, 0, max_cache_space)
Puis, toutes les quelques secondes, il évinçait des trucs jusqu'à ce que le cache tienne là-dedans :
for cache_space > allowed:
  evict(least_recently_used())
À mesure que des Droplets étaient créés et écrivaient sur le disque, disk_free() baissait, allowed baissait avec lui, et le cache rendait son espace. Sur un hyperviseur vide, le cache pouvait grossir jusqu'à 4 Gio. Sur un hyperviseur plein, il rétrécissait jusqu'à zéro. Le buffer_space faisait que le cache commençait à céder la place avant que les Droplets ne ressentent la moindre pression.
Ensuite, il y a la façon dont les blobs entraient dans le cache. Les blobs étaient adressés par leur contenu : vous demandiez à blobcache sha256:ab12cd, pas « ubuntu-14.04 ». Mêmes octets, même clé, donc un blob ne pouvait jamais devenir périmé. En cas de hit, blobcache servait le fichier directement depuis le disque. En cas de miss, il récupérait le blob par HTTP depuis le parc de stockage, et faisait un tee de la réponse vers un fichier temporaire tout en la hachant au passage :
resp := http.Get(storage_url(digest))
staging := os.CreateTemp(staging_dir)
hasher := sha256.New()
return io.TeeReader(resp.Body, io.MultiWriter(staging, hasher))
Donc le lecteur recevait ses octets à mesure qu'ils arrivaient, et un miss ne coûtait rien de plus qu'un téléchargement direct depuis le stockage. La mise en cache se faisait en parallèle, gratuitement.
Quand le flux arrivait à la fin, blobcache vérifiait l'empreinte :
if hasher.Sum() != digest:
  os.Remove(staging)
  return ErrDigestMismatch
if staging.size() > allowed:
  os.Remove(staging)
  return io.EOF
evict_until_fits(staging.size())
os.Rename(staging, cache_path(digest))
return io.EOF
Si l'empreinte ne correspondait pas, le fichier temporaire était jeté et le lecteur recevait une erreur à la place d'un EOF propre, un avertissement : les octets qu'il venait de lire étaient mauvais. Si l'hyperviseur s'était rempli entre-temps, le blob était servi mais pas conservé. Sinon, le fichier temporaire était renommé dans le cache. Le renommage était atomique, donc le cache ne contenait jamais que des blobs complets et vérifiés, et un crash en plein remplissage ne laissait jamais rien d'à moitié écrit derrière lui.
Et comme il s'agissait vraiment de stocker des blobs adressables par contenu, ce n'était pas seulement pour les images disque. C'était pour tout ce qui avait une forme de blob et que vous deviez récupérer sur les hyperviseurs.
Un design cool, des gens frileux
C'était (à mon humble avis) une solution simple et élégante. Mais une chose à laquelle elle se heurtait, c'était le fait que les gens étaient terrifiés à l'idée de faire tourner quoi que ce soit de nouveau sur les hyperviseurs. Ce n'était pas qu'on ne pouvait rien faire, mais il fallait apaiser les craintes avec des arguments convaincants expliquant pourquoi ça aiderait et en quoi ça ne nuirait pas. Passer de NFS à HTTP stressait déjà les gens, et leur dire que j'allais aussi utiliser une partie de leurs précieux SSD pour y fourrer un cache, c'était pousser le bouchon un peu loin.
En même temps, nous venions d'acquérir une nouvelle capacité bien chic : le logging centralisé. Et nous venions aussi de commencer à tout logger au format de logs structurés, en beau JSON. Et notre code backend des hyperviseurs (affectueusement baptisé DOBE) loggait désormais en JSON exactement aux bons endroits.
Quand vous traversez des temps difficiles, parfois il vous faut une séquence montage et parfois il vous faut une simulation. Nous avions tous les ingrédients nécessaires :
- Un système qui génère des événements structurés sur de nombreux hyperviseurs.
- Ces événements historiques sont sauvegardés dans un endroit interrogeable.
- Ces événements enregistrent « quand un hyperviseur donné a demandé une image disque donnée ».
Il était temps de faire une simulation pour montrer que l'introduction de ce cache permettrait d'atteindre un taux de hit suffisant pour justifier le risque.
Simuler deux jours de Droplets à 5 $
Un mardi soir, j'ai lancé une requête sur notre système de logging centralisé pour récupérer la liste de toutes les lignes de log où un hyperviseur avait demandé le téléchargement d'une image disque, au cours des deux derniers jours.
J'ai ensuite modélisé une région cloud en énumérant tous les hyperviseurs impliqués dans les données d'entrée. Ça m'a donné une liste d'hyperviseurs :
hypervisor := [
  // list of all hypervisors
]

type Hypervisor struct {
   cache LRU // holds up to max_size bytes of disk images
}
Et puis j'ai implémenté le modèle de simulation. En rejouant les deux jours d'événements sur le parc d'hyperviseurs, quel aurait été le taux de hit si :
- Il y avait un cache utilisant diverses
eviction_policy? - Le cache avait diverses limites
max_size?
Et la simulation se déroulait comme ceci :
- Un événement arrive pour placer
dropletsurhypervisoren utilisantdisk_image_ubuntude tailleN. - Si
hypervisora déjàdisk_image_ubuntu, enregistrer un hit de cache dans le flux d'événements de sortie. - Sinon, enregistrer un miss de cache dans le flux d'événements de sortie. Puis faire comme si
disk_image_ubuntuétait maintenant en cache surhypervisor. Appliquer l'eviction_policy, quelle qu'elle soit, pour faire de la place si nécessaire. - Répéter sur tout l'ensemble des événements historiques.
C'est assez simple : en gros, on fait comme si le cache était là, et on rejoue les événements qui se sont réellement produits dans le passé, et on peut alors dire :
Si nous avions eu ce cache de
$sizeavec$eviction_policy, le taux de hit du cache aurait été de N.
J'ai relancé la simulation à pleine vitesse pour divers $size afin de montrer que nous aurions ce qui ressemblait à une fonction logarithmique dans l'amélioration des hits de cache : une hausse rapide du taux de hit jusqu'au coude de la courbe, et le coude se situerait quelque part autour de 4 Gio d'espace disque gardé pour le cache. Au-delà, il y avait peu de changement, et c'est avec ça que la proposition est partie, pour apaiser les inquiétudes sur une utilisation excessive du disque. Mais comme vous pouvez le deviner, le décamper-avant-le-tampon aurait permis d'utiliser en gros tout le disque comme cache, mais on a appliqué un plafond pour garder les gens calmes et passer le processus de revue des RFC.
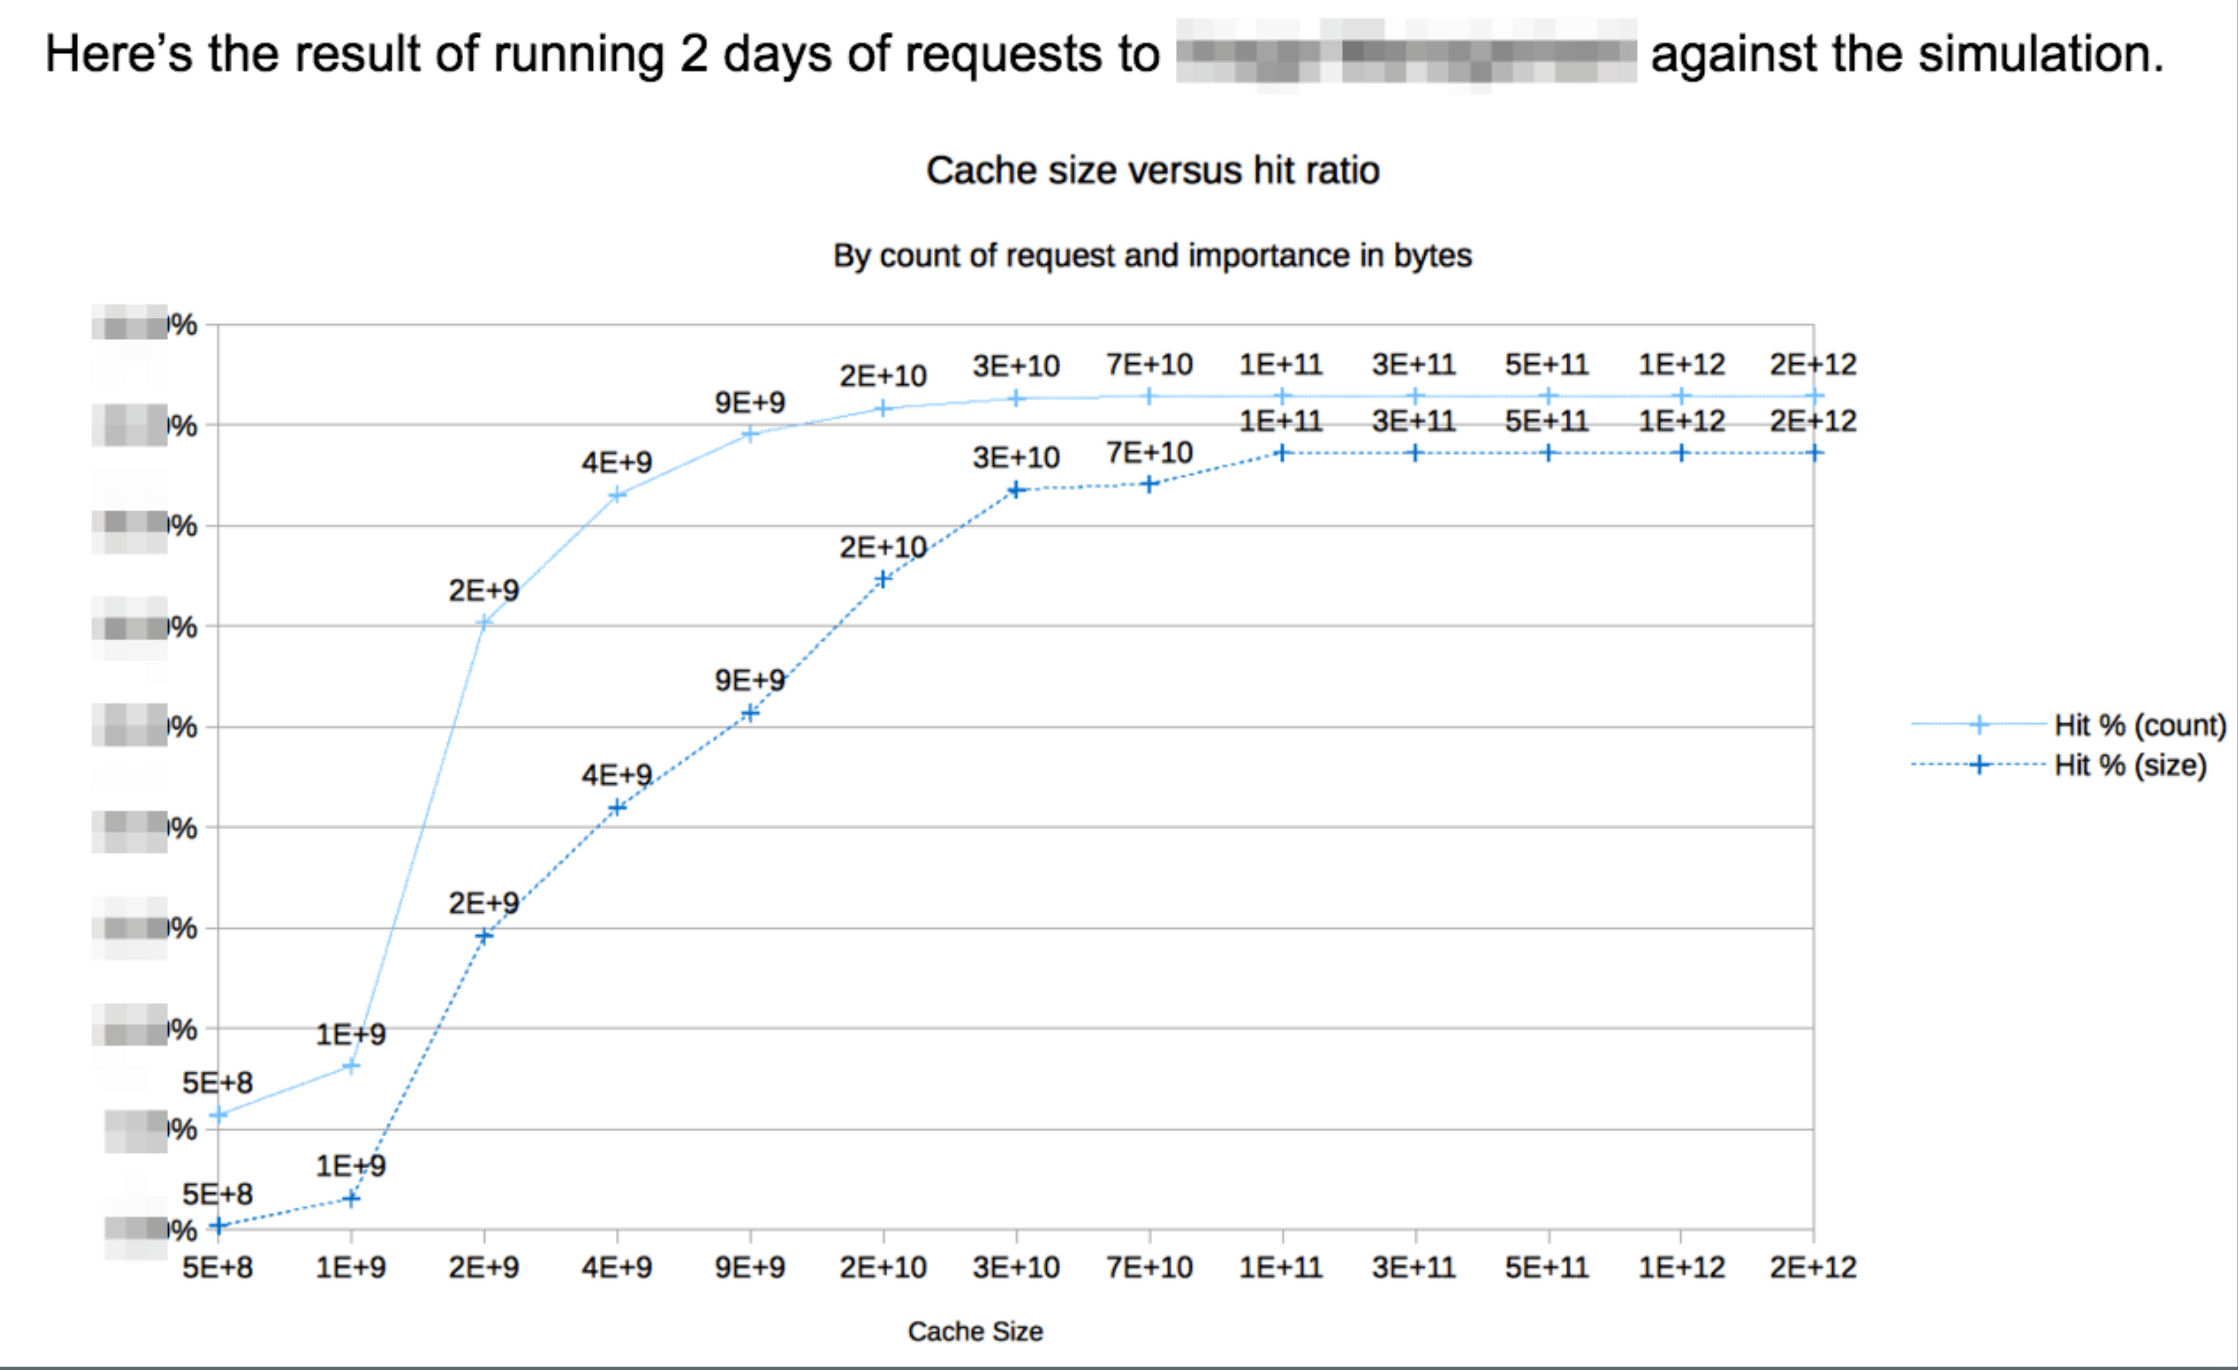
On était déjà jeudi, j'avais fait tout ce travail pendant une rafale de codage frénétique de 48 h. J'ai écrit mon argumentaire dans une RFC, je l'ai balancée sur Slack pour que d'autres la lisent et la passent en revue, et je suis allé dormir jusqu'à lundi.
Le dégel
Et donc mon lundi, quand j'ai rouvert mon portable, blobcache était approuvé. J'en avais aussi déjà implémenté la plus grande partie.
Donc, avec la conception de blobcache, est partie une simulation qui montrait ce que blobcache nous aurait fait gagner dans le passé. Ce n'était pas juste un « faites-moi confiance, ça sera probablement bien », c'était un « si nous l'avions eu, il nous aurait aidés de cette manière, d'une prévisibilité convaincante, et se serait comporté ainsi ». Cela a justifié un essai sur quelques rares hyperviseurs, et une fois prouvé que le code backend ne s'écroulait pas de désespoir à cause de l'usage disque et de la présence du cache (on avait craint qu'utiliser de l'espace disque pour la mise en cache ne casse une obscure comptabilisation des ressources à des fins de placement), il a été déployé sur tout le parc.
Il a ensuite vécu une vie heureuse de taux de hit élevé, à absorber le fort renouvellement des Droplets pour les images disque courantes, pendant de longues et nombreuses années. Pour autant que je sache, il tournait encore des années après mon départ.
La suite
Ce n'était pas la dernière modélisation et simulation que j'ai faite là-bas. Dans la foulée du succès de la gestion d'images, Nick, Justin et moi sommes passés à l'introduction du premier nouveau produit DigitalOcean qui ne soit pas un Droplet : Volumes (stockage en mode bloc attaché au réseau). Cela impliquait encore d'autres types de simulations — des réseaux de flot.
Quant à blobcache, on l'a laissé tranquille jusqu'après Volumes. J'ai brièvement repris le travail sur une v2 qui faisait du gossip pair-à-pair et découpait les blobs en morceaux de taille fixe à l'aide d'arbres de Merkle — à la BitTorrent — et je l'ai abandonnée en plein développement, puisque la v1 était largement suffisante, et de nouveaux chantiers étaient au programme. C'était doux-amer, mais j'ai eu l'occasion de commencer un travail de prototype sur un service d'exécution de conteneurs qui s'est transformé en produit Kubernetes, l'aboutissement de mes années de service chez DigitalOcean ; le lancement de DOKS en route vers l'IPO.