초창기 DigitalOcean은 자사 하이퍼바이저를 건드리기 무서워했다
2014년 당시 DigitalOcean은 초고속 성장 중이었다. 초고속 성장에는 당연히 급격한 확장에서 오는 문제들과 성장통이 따라왔다. 새로운 패러다임이 생기면 새로운 사용자 행동이 나타나는 법이다. DigitalOcean의 경우, 사람들은 Droplet(DigitalOcean이 자사 가상 머신 제품을 부르던 이름)을 무척 좋아해서 만들고, 지우고, 또 만들기를 끝없이 반복했다. Droplet 수는 전체적으로 늘고 있었지만, 그중 상당수는 금방 지워졌다.
5달러로 Subway 30cm 샌드위치, 아니면 SSD Droplet
DigitalOcean이 PMF에 도달했을 때, 창업자인 Ben과 Moisey는 이미 눈에 확 띄는 차별점을 내놓은 상태였다. 당시 클라우드는 아직 막 커 가던 신생 분야였다. 고만고만한 VPS 업체들이 잔뜩 있었고, AWS는 무료 micro VM을 제공하고 있었다. Linode는 전통적인 VPS 업체로, 클릭 몇 번이면 하드 디스크 기반 VM을 만들어 주었다.
DigitalOcean에게는 더 이상 VPS 업체가 아니라 순수 클라우드 사업자가 되겠다는 무모한 야심이 있었고, 망상에 가까울 만큼 AWS를 정조준하고 있었다. 그러기 위해 내세운 한 방은 로컬 SSD 20GB가 달린 512MB Droplet(VM)을 월 5달러에 파는 것이었다. 당시에는 아무도 이렇게 하지 않았다. AWS의 무료 micro VM은 네트워크로 연결된 스토리지를 썼는데 끔찍하게 느렸고, 다른 VPS 업체들은 하드 디스크를 썼다. DigitalOcean은 올플래시였고, 그것도 Subway 30cm 샌드위치 하나 값이었다(Ben은 30cm 샌드위치 얘기를 정말 좋아했다).
야, Subway 30cm 샌드위치 값으로 SSD 달린 VM을 쓸 수 있다고! 끝내주지 않아? - 아마도 Ben Uretsky(DigitalOcean 공동 창업자이자 당시 CEO)가 했을 법한 말
맞아 Ben, 끝내준다. 그리고 DigitalOcean을 지금의 수십억 달러 규모의 클라우드 기업으로 키울 만큼 끝내줬다.
자잘한 Droplet이 잔뜩
그런 상황에 내가 들어왔고, 우리의 말도 안 되는 5달러짜리 SSD Droplet에는 수요가 넘쳐 났다. 이 Droplet들은 하이퍼바이저 노드에 스케줄링되었다. 이 노드들은 비싼 SSD만 잔뜩 들어간 덩치 큰 서버였고, HDD는 단 한 개도 없었다. 그리고 우리는 자잘하고 성가신 512MB VM들을 이 거대한 하이퍼바이저에 잔뜩 채워 넣고 있었다. VM 대부분은 Ubuntu나 Debian 같은 몇 안 되는 인기 Linux 이미지를 돌렸고, 나머지 수많은 이미지는 롱테일을 이뤘다.
이 디스크 이미지들은 꽤 큰 blob이었고(기억에 의존한 어림값으로 p50이 1 GiB, p90이 5 GiB 정도), 어딘가에서 가져와야 했다. 하이퍼바이저의 SSD는 바로 우리가 파는 상품이었으니 거기에 둘 수는 없었다. 디스크 이미지는 스토리지 서버군에 저장되어 있었다. 고객이 Droplet을 주문할 때마다 우리는 그 Droplet을 올릴 하이퍼바이저를 찾고, 하이퍼바이저 코드에 "이 N GiB짜리 이미지를 가져와서 실행해"라고 지시했다. 그런데 이 5달러짜리 Droplet이 불티나게 팔리다 보니, 수많은 사람들이 한꺼번에 Droplet을 만드는 바람에, 하이퍼바이저들이 이 이미지들을 동시에 내려받아야 했다. 그 바람에 네트워크 대역폭을 몽땅 잡아먹었고, 결국 아무도 샌드위치를 먹지 못하는 상황이 벌어졌다. 처음에는 이 모든 걸 NFS로 했는데, NFS는 디스크 이미지가 뭔지도, 그걸 어떻게 다뤄야 하는지도 전혀 몰랐다.
고통을 끌어안고, 고통과 하나가 되어라
이건 별로였다. 우리는 끝내주고 싶었다. 나는 동료 몇 명(Nick Van Wiggeren, Mac Browning, Justin Hines, Matt Layher)과 함께 NFS에서 벗어나 이미지 관리 서비스를 만드는 일에 나섰다. 이 서비스는 디스크 이미지의 전체 생애 주기를 다루고, 디스크 이미지가 무엇인지 '아는' 것이 될 터였다. 디스크 이미지를 다루는 서비스라면 마땅히 갖춰야 할 기능들도 넣을 생각이었다. 이 프로젝트에서는 흥미로운 것들이 많이 나왔고, 이 서비스는 DigitalOcean이 초기 Perl 모놀리스 밖에서 만든 첫 '모던 HTTP/JSON Go 서비스'였다. 오늘 하려는 이야기는 이 프로젝트 막바지에 마주친 문제 하나다. 앞에서 슬쩍 말했던 바로 그 문제, 고객들이 Droplet을 쉴 새 없이 만들고 지웠다는 점이다.
예전 Shopify에서 Tobi는 BFCM이나 플래시 세일 같은 극단적인 트래픽을 끌어안았다. 피할 일이 아니라 반길 일로, 일상처럼 빠르게 처리해 내야 할 일로 봤다. 그곳에서 막 DigitalOcean으로 온 나도 같은 걸 원했다. 사람들이 높은 회전율로 Droplet을 만들고 지울 수 있기를, 그리고 우리가 머리를 굴리고 또 굴려서 그걸 잘 감당하기를 바랐다. 우리가 이걸 잘하기를 바랐다. 우리가 낼 수 있는 가장 빠른 Droplet 생성 속도로 수많은 고객을 기쁘게 하고 싶었다. 이런 Droplet 플래시 세일도 골칫거리가 아니라, 더 빠르게 받아 낼 수 있는 반가운 패턴으로 여기고 싶었다.
그렇다면 Droplet 생성 시간의 99%가 몇 안 되는 스토리지 노드에서 큰 디스크 이미지를 내려받는 데 쓰이던 상황에서, 어떻게 해야 Droplet을 최대한 빨리 띄울 수 있었을까?
캐시는 싫은데 캐싱은 해야 할 때
이 문제의 가장 단순하고 순진한 해법은 디스크 이미지를 하이퍼바이저에 미리 받아 두는 것이었다. 하지만 어떤 이미지가 어디에 필요할지 정확히 알 수 없었다. 수요가 꽤 뒤섞여 있어서, 최신 Ubuntu 말고는 다음에 뭐가 필요할지 뻔하지 않았다. 그러려면 엔지니어들이 "다음엔 이 이미지가 많이 쓰일 것 같은데" 하고 짐작해 가며, 일부 하이퍼바이저에 이미지를 손으로 받아 두고 끊임없이 손봐야 했다. 이건 손이 많이 갔고 좀 땜질식이었다. 게다가 미리 받아 둔 이미지는 전부 하이퍼바이저의 SSD를 차지했다. 그 SSD는 이미지 저장소로 쓸 게 아니라 우리가 팔고 싶은 물건이었다...
그다음으로 뻔한 해법은 요청이 들어올 때마다 이미지를 캐시하는 것이었다. 그러려면... 하이퍼바이저 디스크 공간 일부를 캐시용으로 떼어 놔야 했다. 이것 역시 우리가 이 SSD로 하고 싶었던 일이 아니었다. 우리는 SSD를 월 5달러에 팔고 싶었다.
게다가 이 5달러짜리 Droplet은 당시 황금알을 낳는 거위였고, 사람들은 이걸 망쳐서 Droplet이 더는 돌아가지 않게 될까 봐 죽도록 겁냈다. 거기에 하이퍼바이저에서 돌아가던 거대한 모놀리스 코드는 아무도 절대 건드리고 싶어 하지 않는 엉망진창 Perl 덩어리였다. 한마디로 이 하이퍼바이저에 손대는 일이라면, 담당자는 누구든 코르티솔 수치가 치솟았다. 그리고 우리에겐 그 코드베이스를 맡은 팀의 지지가 필요했다.
그래서 우리의 자유도 중 일부는 제약을 받고 있었다:
- 미리 받아 두는 데 SSD 공간을 낭비하고 싶지 않았다
- 캐싱에 SSD 공간을 낭비하고 싶지 않았다
- 하이퍼바이저는 건드리는 것 자체가 무서웠다
숨은 자유도
하지만 한눈에 보이지 않던 점이 하나 있었다.
- 우리가 SSD 디스크 공간을 캐싱용으로 떼어 두고 싶지 않았던 건 결국 그걸 팔고 싶었기 때문이었다.
- 하이퍼바이저에 Droplet이 하나도 없을 때(판매율 0%) 캐싱에 쓸 수 있는 디스크 공간이 가장 많았다.
- 하이퍼바이저가 가득 차 갈 때 캐싱에 쓸 수 있는 디스크 공간이 가장 적었다.
- 하이퍼바이저가 아직 비어 있을 때는 디스크 공간을 낭비해도 괜찮았다.
- 하이퍼바이저 용량이 거의 다 팔렸을 때는 디스크 공간을 낭비할 여유가 없었다.
- 하이퍼바이저 스택을 NFS에서 HTTP로 바꾸면서 새로운 코드 경로를 도입하고 있었으니, 우리에게는 이 코드를 건드릴 조직 차원의 명분이 어느 정도 있었다.
그러니까 결국 하이퍼바이저가 차오를 때 우리가 비켜 주기만 한다면, 캐싱은 괜찮았다. 숨은 자유도는 캐시가 쓰는 디스크 공간을 Droplet의 디스크 사용량에 반비례하게 조절하는 것이었다.
Blobcache: 스스로 줄어드는 캐시
그래서 나는 스스로 줄어드는 캐시인 blobcache를 설계했다. 이 캐시는 하이퍼바이저 SSD를 정해진 한도까지만 썼고, 여유 공간이 늘 일정한 버퍼 이상 남아 있도록 지켜봤다.
max_cache_space := 4 GiB
buffer_space := 2 GiB
min_free_space := 10 GiB
캐시는 디스크의 여유 공간을 보고 캐시를 얼마나 유지해도 되는지 계산했다. 여유 공간 중 min_free_space + buffer_space를 넘는 부분은 max_cache_space까지 마음대로 써도 됐다:
headroom := disk_free() - min_free_space - buffer_space
allowed := clamp(cache_space + headroom, 0, max_cache_space)
그리고 몇 초마다, 캐시 크기가 allowed 안으로 들어올 때까지 항목을 하나씩 내보냈다:
for cache_space > allowed:
  evict(least_recently_used())
Droplet이 만들어지고 디스크에 쓰면 disk_free()가 줄어들고, allowed도 함께 줄어들고, 캐시는 자기 공간을 돌려주었다. 빈 하이퍼바이저에서는 캐시가 4 GiB까지 커질 수 있었다. 가득 찬 하이퍼바이저에서는 캐시가 하나도 남지 않을 때까지 줄어들었다. buffer_space 덕분에 캐시는 Droplet이 압박을 느끼기 전에 비켜 주기 시작했다.
다음은 blob이 캐시에 들어가는 방식이었다. blob은 콘텐츠 주소 기반이었다. 즉 blobcache에는 "ubuntu-14.04"가 아니라 sha256:ab12cd로 요청했다. 바이트가 같으면 키도 같으니, blob이 낡은 데이터가 될 일이 없었다. 히트일 때 blobcache는 디스크에서 바로 파일을 내주었다. 미스일 때는 스토리지 서버군에서 HTTP로 blob을 가져오고, 응답을 tee해서 임시 파일에도 쓰면서 그 과정에서 해시도 계산했다:
resp := http.Get(storage_url(digest))
staging := os.CreateTemp(staging_dir)
hasher := sha256.New()
return io.TeeReader(resp.Body, io.MultiWriter(staging, hasher))
그래서 읽는 쪽은 바이트가 도착하는 대로 받았고, 미스가 나도 스토리지에서 직접 내려받는 것 이상의 비용은 들지 않았다. 캐싱은 덤으로 따라왔다.
스트림을 끝까지 읽으면 blobcache는 해시를 확인했다:
if hasher.Sum() != digest:
  os.Remove(staging)
  return ErrDigestMismatch
if staging.size() > allowed:
  os.Remove(staging)
  return io.EOF
evict_until_fits(staging.size())
os.Rename(staging, cache_path(digest))
return io.EOF
해시가 맞지 않으면 임시 파일은 버려졌고, 읽는 쪽은 정상적인 EOF 대신 오류를 받았다. 그 오류는 방금 읽은 바이트가 잘못됐다는 경고였다. 그사이에 하이퍼바이저가 가득 찼다면, blob은 전달은 됐지만 보관되지는 않았다. 그 밖의 경우에는 임시 파일의 이름이 바뀌어 캐시로 들어갔다. 이름 변경은 원자적이었으므로 캐시에는 항상 완전하고 검증된 blob만 있었다. 그리고 캐시를 채우는 도중에 크래시가 나도 반쯤 쓰다 만 것이 남는 일은 없었다.
그리고 결국 하는 일은 콘텐츠 주소 기반 blob 저장이었으니, 디스크 이미지 전용일 이유가 없었다. 하이퍼바이저로 받아 와야 하는 blob 형태의 것이라면 무엇이든 그 대상이었다.
밥 주는 손을 물(지 마)라
이건 (내 소견으로는) 단순하고 우아한 해법이었다. 하지만 이 해법에는 걸림돌이 하나 있었다. 사람들은 하이퍼바이저에서 새로운 걸 돌리는 것 자체를 끔찍이 두려워했다. 아무것도 못 하는 건 아니었지만, 이게 왜 도움이 되고 왜 해가 되지 않는지, 설득력 있는 근거로 두려움을 달래야 했다. NFS에서 HTTP로 바꾸는 것만으로도 사람들은 이미 스트레스를 받고 있었다. 거기에 그 귀하신 SSD 일부를 써서 캐시까지 쑤셔 넣겠다고 하는 건 좀 무리한 요구였다.
그 무렵 우리는 근사한 새 기능, 중앙 집중식 로깅을 막 갖춘 참이었다. 또 모든 걸 구조화된 로그 형식, 아름다운 JSON으로 남기기 시작한 참이었다. 하이퍼바이저 백엔드 코드(애칭은 DOBE)도 이제 딱 필요한 지점마다 JSON 로그를 남기고 있었다.
힘든 시기가 오면 때로는 훈련 몽타주가 필요하고, 때로는 시뮬레이션이 필요하다. 우리에겐 필요한 재료가 다 있었다:
- 여러 하이퍼바이저에 걸쳐 구조화된 이벤트를 만들어 내는 시스템이 있었다.
- 이 과거 이벤트들은 쿼리할 수 있는 곳에 저장되어 있었다.
- 이 이벤트들은 "어떤 하이퍼바이저가 어떤 디스크 이미지를 언제 요청했는지"를 기록하고 있었다.
이제 시뮬레이션으로, 이 캐시를 도입하면 위험을 감수할 만한 적중률이 나온다는 걸 보여 줄 때였다.
5달러 Droplet 이틀 치 시뮬레이션하기
어느 화요일 저녁, 나는 중앙 집중식 로깅 시스템에 쿼리를 날려, 지난 이틀 동안 하이퍼바이저가 디스크 이미지 다운로드를 요청한 로그 줄을 전부 가져왔다.
그다음 입력 데이터에 등장한 하이퍼바이저를 전부 나열해서 클라우드 리전 하나를 모델링했다. 그렇게 하이퍼바이저 목록을 얻었다:
hypervisor := [
  // list of all hypervisors
]

type Hypervisor struct {
   cache LRU // holds up to max_size bytes of disk images
}
그리고 시뮬레이션 모델을 구현했다. 이틀 치 이벤트를 하이퍼바이저 서버군에 리플레이했을 때, 다음과 같았다면 적중률은 얼마였을까:
- 다양한
eviction_policy를 쓰는 캐시가 있었다면? - 캐시의
max_size상한이 여러 가지였다면?
시뮬레이션은 이렇게 돌아갔다:
- 크기가
N인disk_image_ubuntu를 써서droplet을hypervisor에 스케줄링하라는 이벤트가 들어왔다. hypervisor에 이미disk_image_ubuntu가 있으면, 출력 이벤트 스트림에 캐시 히트를 기록했다.- 없으면, 출력 이벤트 스트림에 캐시 미스를 기록했다. 그리고 이제
disk_image_ubuntu가hypervisor에 캐시되었다고 가정했다. 필요하면 해당eviction_policy를 적용해 공간을 만들었다. - 과거 이벤트 전체에 대해 이를 반복했다.
꽤 단순하다. 기본적으로 캐시가 있다고 가정하고, 과거에 실제로 일어난 이벤트를 리플레이한다. 그러면 이렇게 말할 수 있다:
$eviction_policy를 쓰는$size크기의 캐시가 있었다면, 캐시 적중률은 N이었을 것이다.
나는 여러 $size에 대해 시뮬레이션을 최대 속도로 다시 돌렸다. 그 결과 캐시 히트 개선 폭이 로그 함수 같은 모양을 그렸다는 걸 보여 줄 수 있었다. 곡선이 꺾이는 지점까지는 적중률이 빠르게 올라갔고, 그 지점은 캐시용 디스크 공간 4 GiB 언저리였다. 그 이상에서는 변화가 거의 없었고, 그래서 과도한 디스크 사용에 대한 걱정을 덜기 위해 제안서에는 4 GiB를 담았다. 눈치챘겠지만, 캐시는 버퍼에 닿기 전에 알아서 물러나니 사실상 디스크 전체를 캐시로 써도 됐을 것이다. 하지만 사람들을 안심시키고 RFC 리뷰 절차를 통과하기 위해 상한을 걸었다.
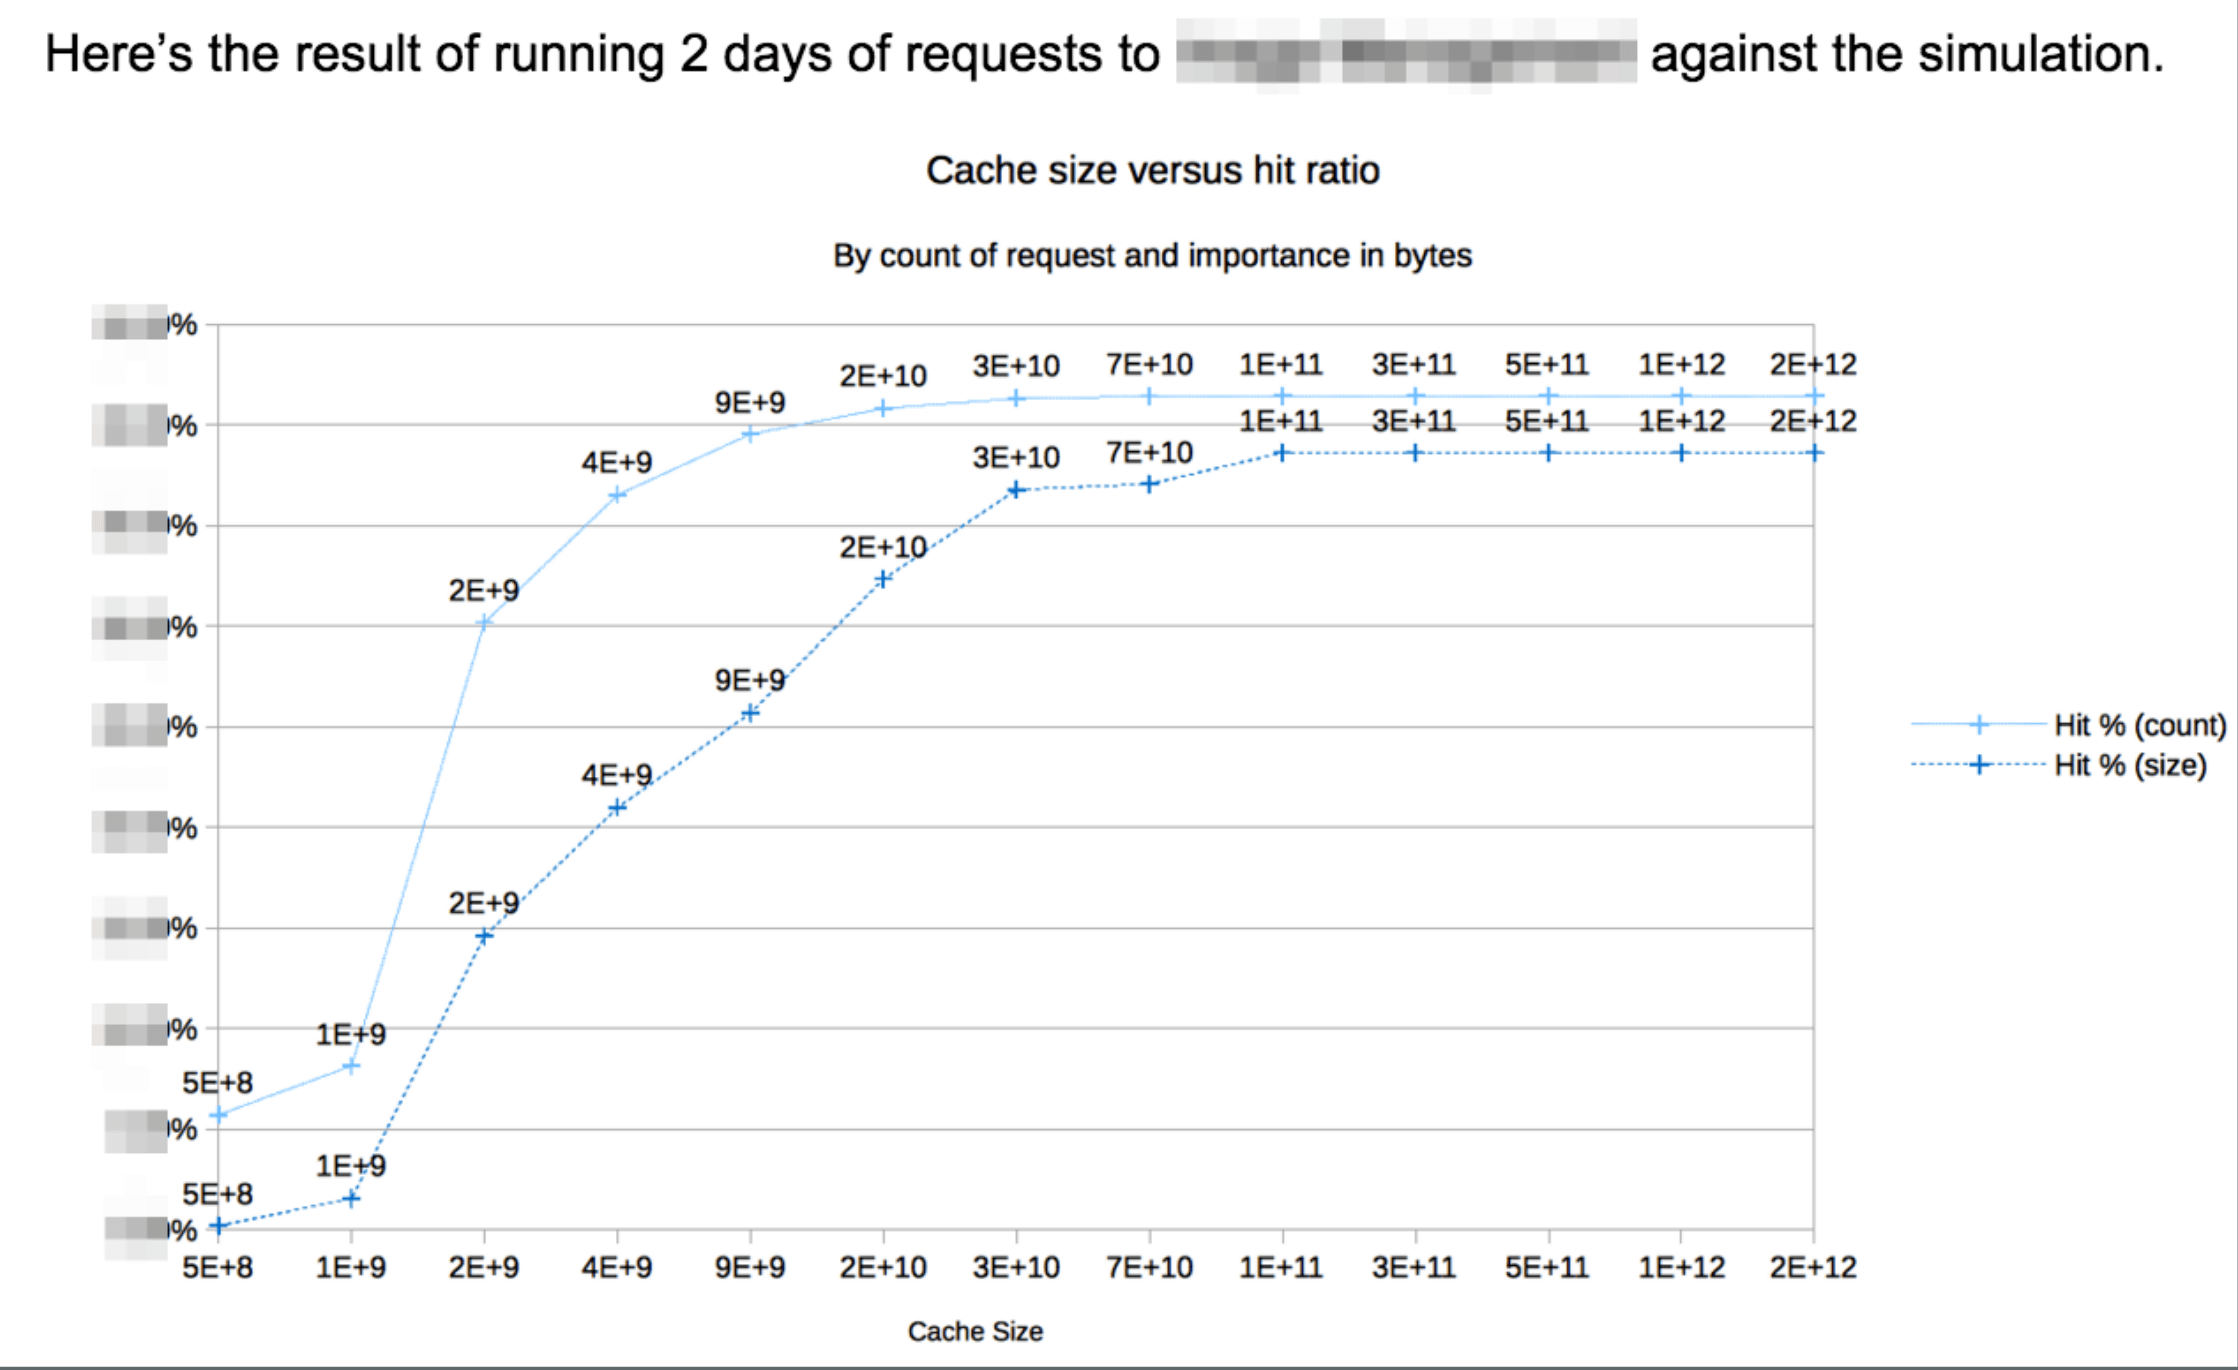
어느새 목요일이었다. 나는 이 모든 작업을 48시간 동안 몰아친 광란의 코딩으로 해치웠다. 내 주장을 RFC로 정리해 다른 사람들이 읽고 리뷰하도록 Slack에 올려 두고, 월요일까지 잤다.
서서히 달아오른 반응
그렇게 월요일에 다시 노트북을 열었을 때, blobcache는 승인되어 있었다. 나는 이미 그 대부분을 구현해 둔 상태이기도 했다.
정리하면, blobcache 설계안은 blobcache가 그동안 있었다면 무엇을 얻었을지 보여 주는 시뮬레이션과 함께 올라갔다. 이건 그저 "날 믿어, 아마 괜찮을 거야"가 아니었다. "이게 있었다면 이만큼 도움이 됐을 것이고, 이렇게 동작했을 것이다"라는 근거 있는 예측이었다. 덕분에 몇몇 하이퍼바이저에서 시험 운영을 할 명분이 생겼다. 걱정거리는 하나 있었다. 캐시가 디스크를 쓰면, 스케줄링에 쓰이던 잘 알려지지 않은 디스크 사용량 집계가 망가질 수 있었다. 시험 운영에서 백엔드 코드가 캐시의 존재나 디스크 사용에 기겁하지 않고 멀쩡히 동작한다는 게 확인되자, blobcache는 서버군 전체에 배포되었다.
그 뒤로 blobcache는 인기 이미지로 Droplet을 쉴 새 없이 만들고 지우는 부하를 높은 적중률로 받아 내며, 오래오래 행복하게 살았다. 내가 아는 한, 내가 떠나고 몇 년이 지나서도 여전히 돌아가고 있었다.
그다음
그곳에서 내가 한 모델링과 시뮬레이션은 이게 마지막이 아니었다. 이미지 관리 프로젝트의 성공에 힘입어, Nick, Justin, 그리고 나는 DigitalOcean이 Droplet 말고 처음 내놓는 제품인 Volumes(네트워크 연결 블록 스토리지) 출시로 넘어갔다. 여기에는 또 다른 종류의 시뮬레이션, 즉 유량 네트워크가 필요했다.
blobcache는 Volumes 이후까지 그대로 남아 있었다. 나는 잠깐 v2 작업을 다시 시작했다. v2는 가십 기반 P2P로 동작하고, 머클 트리를 써서 blob을 고정 크기 청크로 쪼개는 BitTorrent 방식이었다. 하지만 v1으로도 대체로 충분했고 새로운 일이 잡혀 있었기 때문에, 개발 도중에 접었다. 시원섭섭했지만, 나는 컨테이너 런타임 서비스의 프로토타입 작업을 시작할 기회를 얻었고, 그 서비스는 나중에 Kubernetes 제품으로 발전했다. 이 작업은 DigitalOcean 시절 내 커리어의 정점이 되었고, IPO로 가는 길목에서 DOKS 출시로 이어졌다.