DigitalOcean의 5달러 SSD Droplet 시뮬레이션하기
2014년 당시, DigitalOcean은 하이퍼그로스를 겪고 있었다. 하이퍼그로스와 함께 당연히 급격한 확장 문제와 성장통이 찾아왔다. 새로운 패러다임과 함께, 새로운 사용자 행동이 나타난다. 이 경우, 사람들은 Droplet(DigitalOcean이 자사의 가상 머신 제품을 부르던 이름)을 정말 좋아했고, 계속해서 새로 만들고 지우고 또 만들고 하는 식이었다. 전반적인 성장, 그리고 Droplet 개체 중 상당수는 수명이 짧았다.
5달러짜리 풋롱 Subway 샌드위치, 또는 SSD Droplet
DigitalOcean이 PMF에 도달했을 때, 창업자 Ben과 Moisey는 눈길을 끄는 차별점을 생각해 냈다. 당시 클라우드는 아직 막 피어나는 새로운 분야였고, 고만고만한 VPS 업체들과 함께 AWS는 무료 마이크로 VM을 제공하고 있었다. Linode는 회전식 디스크를 쓰는 클릭클릭클릭 VM을 제공하는 전통적인 VPS였다.
DigitalOcean은 더 이상 VPS 업체이고 싶지 않고 대신 AWS를 망상적으로 겨냥한 순수 클라우드 사업자가 되고 싶어 하는 오만을 품고 있었다. 그러기 위해, 기믹은 로컬에 연결된 20GB SSD를 단 512MB Droplet(VM)을 월 5달러에 파는 것이었다. 당시에는 아무도 이렇게 하고 있지 않았다. AWS의 무료 마이크로 VM은 네트워크 연결 스토리지였는데 굼벵이처럼 느렸고, 다른 VPS 업체들은 회전식 디스크였다. DigitalOcean은 전부 플래시였고, 그것도 고작 풋롱 Subway 샌드위치 하나 값이었다 (Ben은 풋롱 샌드위치 얘기를 그냥 정말 좋아했다).
이봐, 풋롱 Subway 하나 값으로 SSD 달린 VM을 가질 수 있어! 멋지지 않아! - 아마 Ben Uretsky(DigitalOcean 공동창업자이자 당시 CEO)가 했을 법한 말
그래, Ben, 멋지다. 그리고 그건 DigitalOcean이 지금은 수십억 달러 규모의 클라우드 업체가 될 만큼 충분히 멋졌다.
수많은 작은 Droplet
그렇게 내가 왔고, 우리에게는 말도 안 되는 5달러 SSD Droplet에 대한 이 모든 수요가 있었다. 이 Droplet들은 하이퍼바이저 노드에 스케줄링될 예정이었다. 이 노드들은 비싼 SSD만 잔뜩 꽂힌 크고 뚱뚱한 서버였다: 돌아가는 녹슨 원판은 전혀 없었다. 그리고 우리는 이 거대한 하이퍼바이저들에 자그맣고 성가신 512MB VM을 잔뜩 욱여넣고 있었고, 이 VM 각각은 똑같은 몇 가지 Ubuntu나 Debian이나 뭐든 그런 Linux 이미지, 그리고 다른 이미지들의 꼬리를 실행하고 싶어 했다.
이 디스크 이미지들은 꽤 큰 블롭이었고 (기억에 의존한 어림짐작으로 p50은 1 GiB, p90은 5 GiB) 어딘가에서 와야 했는데, 하이퍼바이저의 SSD는 그 어딘가가 아니었다. 그게 바로 우리가 팔고 있던 것이었으니까. 디스크 이미지는 스토리지 서버군에 저장되어 있었고, 고객이 우리에게 Droplet을 주문할 때마다 우리는 그것을 위한 하이퍼바이저를 찾아서, 하이퍼바이저 코드에 "이 N GiB 이미지를 가져와서 실행해"라고 말했다. 그러고 나서 이 5달러 Droplet이 불티나게 팔렸기 때문에, 한 무리의 사람들이 모두 하이퍼바이저군으로 이 모든 이미지를 전부 동시에 끌어오려 하는 상황이 생겼고, 네트워크를 완전히 잡아먹어 아무도 샌드위치를 못 먹는 결과로 이어졌다. 이 모든 건 처음에 NFS로 이루어졌는데, NFS는 디스크 이미지가 무엇인지, 그리고 그것을 디스크 이미지답게 어떻게 다뤄야 하는지에 대한 개념이 없었다.
고통을 끌어안고, 고통이 되어라
이건 훌륭하지 않았다. 우리는 훌륭하고 싶었다. 내 친구 몇 명과 나(Nick Van Wiggeren, Mac Browning, Justin Hines, Matt Layher)는 NFS에서 벗어나 이미지 관리 서비스를 만드는 임무에 나섰다. 이것은 디스크 이미지의 전체 생애 주기를 다루고, 디스크 이미지가 무엇인지 "알고", 디스크 이미지에 대해 알고 그것을 제공하는 무언가에게서 우리가 필요로 하는 여러 가지를 해낼 것이었다. 이 전체 프로젝트에서 흥미로운 것들이 많이 나왔는데, DigitalOcean이 초기 Perl 모놀리스 바깥에서 만든 첫 "현대적인 HTTP/JSON Go 서비스"였다. 그리고 이 프로젝트의 끝자락에 오늘 이야기하고 싶은 특정한 문제가 하나 있었다. 그리고 앞에서 넌지시 말했듯이: 우리 고객들이 아주 높은 속도로 Droplet을 갈아 치우기를 얼마나 즐겼는지.
Shopify 시절, Tobi는 BFCM과 플래시 세일을 반겨야 할, 그리고 평범하고 빠른 일로 만들어야 할 병적인 사용자 패턴으로 여기며 끌어안았었다. 그곳에서 막 DigitalOcean으로 온 참이라, 나도 같은 걸 원했다. 나는 사람들이 Droplet을 갈아 치울 수 있기를, 그리고 우리가 우리 머리와 두뇌를 써서 그것을 잘 처리하기를 원했다. 나는 우리가 이걸 잘하기를 원했다. 우리가 제공할 수 있는 가장 빠른 Droplet 생성 경험으로 고객을 감동시키기를, 대규모로, 그리고 이 Droplet 플래시 세일을 우리가 가속하고 빠르게 만들 멋진 패턴으로 반기기를.
그래서 시작하는 데 걸리는 시간의 99%가 소수의 스토리지 노드에서 큰 디스크 이미지를 내려받는 데 쓰일 때, 어떻게 이 Droplet들이 최대한 빨리 시작하게 할 수 있을까?
원치 않을 때 캐싱하기
이에 대한 나이브하고 가장 단순한 해법은 디스크 이미지를 하이퍼바이저에 미리 배치하는 것이다. 하지만 그러면 우리는 어떤 이미지가 어디에 필요할지 정확히 알지 못했고, 수요가 충분히 뒤섞여 있어서 최신 Ubuntu를 빼면 다음에 무엇이 올지가 뻔하지 않았다. 몇몇 하이퍼바이저에 디스크 이미지를 수동으로 배치하는 엔지니어들이 끊임없이 이리저리 손보며 반응적으로 "다음엔 사람들이 이 이미지를 원할 것 같아" 하지 않는 한은. 이건 손이 많이 가고 좀 땜질식이다. 그리고 또, 이렇게 미리 배치된 디스크 이미지들은 모두 우리가 디스크 이미지 저장소로 쓰는 게 아니라 팔고 싶은 하이퍼바이저 SSD의 공간을 쓰고 있다...
그다음으로 또 뻔한 해법은 이미지가 요청될 때 캐싱하는 것이다. 그래서 그러면 우리는... 캐시를 위해 하이퍼바이저 디스크 공간의 일부를 예약해야 하는데, 이 역시 우리가 이 SSD로 하고 싶은 일이 아니다: 우리는 그것을 월 5달러에 팔고 싶다.
게다가, 이 5달러 Droplet은 당시 황금알을 낳는 거위였고, 사람들은 이걸 망쳐서 Droplet이 더 이상 작동하지 않게 될까 봐 지독하게 겁먹고 있었다. 거기에 더해, 하이퍼바이저에서 돌아가는 거대한 모놀리스 코드는 아무도 절대 건드리고 싶어 하지 않는 Perl 덩어리 엉망진창이었다. 기본적으로 이 하이퍼바이저에서 뭔가를 하는 것은 그것을 책임지는 누구에게나 코르티솔 수치를 올리는 일이었다. 그리고 우리는 그 코드베이스를 다루는 팀의 지지가 필요했다.
그래서 우리의 자유도 중 일부는 제약되어 있었다:
- 우리는 미리 배치하는 데 SSD 공간을 낭비하고 싶지 않았다
- 우리는 캐싱에 SSD 공간을 낭비하고 싶지 않았다
- 우리는 하이퍼바이저를 건드리는 것 자체가 무서웠다
숨은 자유도
하지만 명백하지 않았던 것이 하나 있다.
- 우리는 궁극적으로 SSD 디스크 공간을 캐싱용으로 예약하고 싶지 않았는데, 그걸 팔고 싶었기 때문이다.
- 하이퍼바이저에 Droplet이 하나도 없을 때 (0% 판매) 캐싱에 쓸 수 있는 디스크 공간이 가장 많았다.
- 하이퍼바이저가 가득 차 갈 때 캐싱에 쓸 수 있는 디스크 공간이 가장 적었다.
- 하이퍼바이저가 안 팔렸을 때는 디스크 공간을 낭비할 여유가 있었다.
- 하이퍼바이저가 매진에 가까워질 때는 디스크 공간을 낭비할 여유가 없었다.
- 우리는 하이퍼바이저 스택을 NFS에서 HTTP로 바꾸고 새로운 경로를 도입하고 있었기 때문에, 이 코드를 건드리는 데 어느 정도 제도적 정당성이 있었다.
그러니까 기본적으로, 캐싱은 하이퍼바이저가 차오르는 동안 우리가 비켜 주기만 한다면 괜찮았다. 자유도: Droplet의 디스크 사용량에 반비례하여 디스크 공간을 캐싱에 사용한다.
Blobcache: 스스로 줄어드는 캐시
그래서 나는 blobcache, 스스로 줄어드는 캐시를 설계했다. 이 캐시는 하이퍼바이저 SSD에서 어떤 고정된 양을 사용하고, 버퍼를 감시해서 항상 일정한 버퍼 크기의 빈 공간을 유지할 것이었다.
max_cache_space := 4 GiB
buffer_space := 2 GiB
min_free_space := 10 GiB
이 캐시는 디스크 빈 공간을 보고 캐시를 얼마나 유지해도 되는지 알아낼 것이었다. min_free_space + buffer_space 위로 남은 여유 공간은 무엇이든, max_cache_space까지, 가져다 써도 되는 몫이었다:
headroom := disk_free() - min_free_space - buffer_space
allowed := clamp(cache_space + headroom, 0, max_cache_space)
그러고 나서 몇 초마다, 캐시가 그 한도 안에 들어올 때까지 이것저것 축출했다:
for cache_space > allowed:
  evict(least_recently_used())
Droplet이 생성되고 디스크에 쓰면서 disk_free()는 내려가고, allowed도 함께 내려가고, 캐시는 자기 공간을 돌려줬다. 빈 하이퍼바이저에서는 캐시가 4 GiB까지 자랄 수 있었다. 가득 찬 하이퍼바이저에서는 아무것도 없을 때까지 줄어들었다. buffer_space는 Droplet이 어떤 압박이든 느낄 수 있기 전에 캐시가 비켜 주기 시작한다는 뜻이었다.
그다음은 블롭이 캐시에 어떻게 들어가느냐다. 블롭은 콘텐츠 주소 지정 방식이었다: blobcache에 "ubuntu-14.04"가 아니라 sha256:ab12cd를 요청하는 식이었다. 같은 바이트, 같은 키, 그래서 블롭이 오래된 데이터가 될 수 없었다. 히트가 나면, blobcache는 파일을 디스크에서 바로 제공했다. 미스가 나면, 스토리지 서버군에서 HTTP로 블롭을 가져와서, 응답을 tee해서 스테이징 파일에도 쓰고 그러는 동안 해시를 계산했다:
resp := http.Get(storage_url(digest))
staging := os.CreateTemp(staging_dir)
hasher := sha256.New()
return io.TeeReader(resp.Body, io.MultiWriter(staging, hasher))
그래서 읽는 쪽은 바이트가 도착하는 대로 받았고, 미스는 스토리지에서 직접 내려받는 것 이상의 비용이 들지 않았다. 캐싱은 곁다리로, 공짜로 일어났다.
스트림이 끝에 닿으면, blobcache는 해시를 확인했다:
if hasher.Sum() != digest:
  os.Remove(staging)
  return ErrDigestMismatch
if staging.size() > allowed:
  os.Remove(staging)
  return io.EOF
evict_until_fits(staging.size())
os.Rename(staging, cache_path(digest))
return io.EOF
해시가 맞지 않으면, 스테이징 파일은 버려지고 읽는 쪽은 깔끔한 EOF 대신 에러를 받았는데, 방금 읽은 바이트가 잘못됐다는 경고였다. 그사이에 하이퍼바이저가 가득 찼다면, 블롭은 제공되었지만 보관되지는 않았다. 그렇지 않으면, 스테이징 파일은 이름이 바뀌어 캐시 안으로 들어갔다. 이름 바꾸기는 원자적이었으므로, 캐시는 언제나 완전하고 검증된 블롭만 담았고, 채우는 도중 크래시가 나도 반쯤 쓰인 것을 남기지 않았다.
그리고 이건 사실 콘텐츠 주소 지정 방식의 블롭을 저장하는 것에 관한 것이었기 때문에, 디스크 이미지만을 위한 게 아니었다. 하이퍼바이저로 가져와야 하는 블롭 모양의 것이라면 무엇에든 쓰이는 것이었다.
쿨한 설계, 얼어붙은 사람들
이건 (내 짧은 소견으로는) 단순하고 우아한 해법이었다. 하지만 이것이 거스르고 있던 한 가지는 사람들이 하이퍼바이저에서 새로운 걸 돌리는 걸 끔찍하게 무서워했다는 사실이었다. 우리가 아무것도 할 수 없었던 건 아니지만, 그것이 왜 도움이 되고 어떻게 해를 끼치지 않을지에 대한 설득력 있는 논거로 두려움을 달래야 했다. NFS에서 HTTP로 바꾸는 것만으로도 이미 사람들은 스트레스를 받고 있었고, 거기에 그들의 소중한 SSD 일부를 써서 캐시를 쑤셔 넣겠다고까지 말하는 건 좀 무리였다.
동시에, 우리는 막 근사한 새 기능을 얻은 참이었다: 중앙 집중식 로깅. 그리고 우리는 또한 막 모든 것을 아름다운 JSON 형식의 구조화된 로그로 남기기 시작한 참이었다. 그리고 우리 하이퍼바이저 백엔드 코드(애정을 담아 DOBE라고 이름 붙인)는 이제 딱 맞는 지점들에서 JSON으로 로그를 남기고 있었다.
힘든 시기를 마주할 때, 때로는 몽타주 장면이 필요하고 때로는 시뮬레이션이 필요하다. 필요한 재료는 다 갖춰져 있었다:
- 많은 하이퍼바이저에 걸쳐 구조화된 이벤트를 생성하는 시스템.
- 이 과거 이벤트들은 쿼리할 수 있는 어딘가에 저장된다.
- 이 이벤트들은 "특정 하이퍼바이저가 특정 디스크 이미지를 요청한 때"를 기록한다.
이 캐시를 도입하면 위험을 정당화할 만한 히트율을 달성한다는 것을 보여 줄 시뮬레이션을 할 때였다.
5달러 Droplet의 이틀을 시뮬레이션하기
어느 화요일 저녁, 나는 중앙 집중식 로깅 시스템에 쿼리를 날려서 지난 이틀 동안 하이퍼바이저가 디스크 이미지 다운로드를 요청한 모든 로그 줄의 목록을 가져왔다.
나는 그다음 입력 데이터에 관련된 모든 하이퍼바이저를 열거해서 클라우드 리전을 모델링했다. 이렇게 하이퍼바이저 목록을 얻었다:
hypervisor := [
  // list of all hypervisors
]

type Hypervisor struct {
   cache LRU // holds up to max_size bytes of disk images
}
그러고 나서 나는 시뮬레이션 모델을 구현했다. 이틀간의 이벤트를 하이퍼바이저군에 대해 재생하면, 다음과 같은 경우 히트율은 얼마였을까:
- 다양한
eviction_policy를 쓰는 캐시가 있었다면? - 캐시에 다양한
max_size제한이 있었다면?
그리고 시뮬레이션은 이렇게 진행됐다:
- 크기
N인disk_image_ubuntu를 사용해droplet을hypervisor에 스케줄링하라는 이벤트가 온다. hypervisor에 이미disk_image_ubuntu가 있으면, 출력 이벤트 스트림에 캐시 히트를 기록한다.- 없으면, 출력 이벤트 스트림에 캐시 미스를 기록한다. 그다음
disk_image_ubuntu가 이제hypervisor에 캐시되어 있는 척한다. 필요하면 공간을 만들기 위해 어떤eviction_policy든 적용한다. - 과거 이벤트 전체에 걸쳐 반복한다.
꽤 단순하다, 기본적으로 캐시가 있는 척하고, 과거에 실제로 일어났던 이벤트를 재생하고, 그러면 이렇게 말할 수 있다:
$eviction_policy를 쓰는$size짜리 이 캐시가 있었다면, 캐시 히트율은 N이었을 것이다.
나는 다양한 $size에 대해 시뮬레이션을 최대 속도로 다시 돌려서, 캐시 히트 개선이 로그 함수처럼 보이는 모양이 된다는 것을 보여 주었다: 곡선의 무릎까지 히트율이 빠르게 증가하고, 그 무릎은 캐시용으로 확보한 디스크 공간 약 4 GiB 언저리에 있었다. 그 너머로는 변화가 거의 없었고, 과도한 디스크 사용에 대한 걱정을 덜기 위해 제안서는 그 값으로 나갔다. 하지만 짐작할 수 있듯이, 버퍼-앞-줄행랑은 사실상 디스크 전체를 캐시로 쓰는 것도 허용했을 테지만, 사람들을 진정시키고 RFC 검토 절차를 통과하기 위해 상한이 적용되었다.
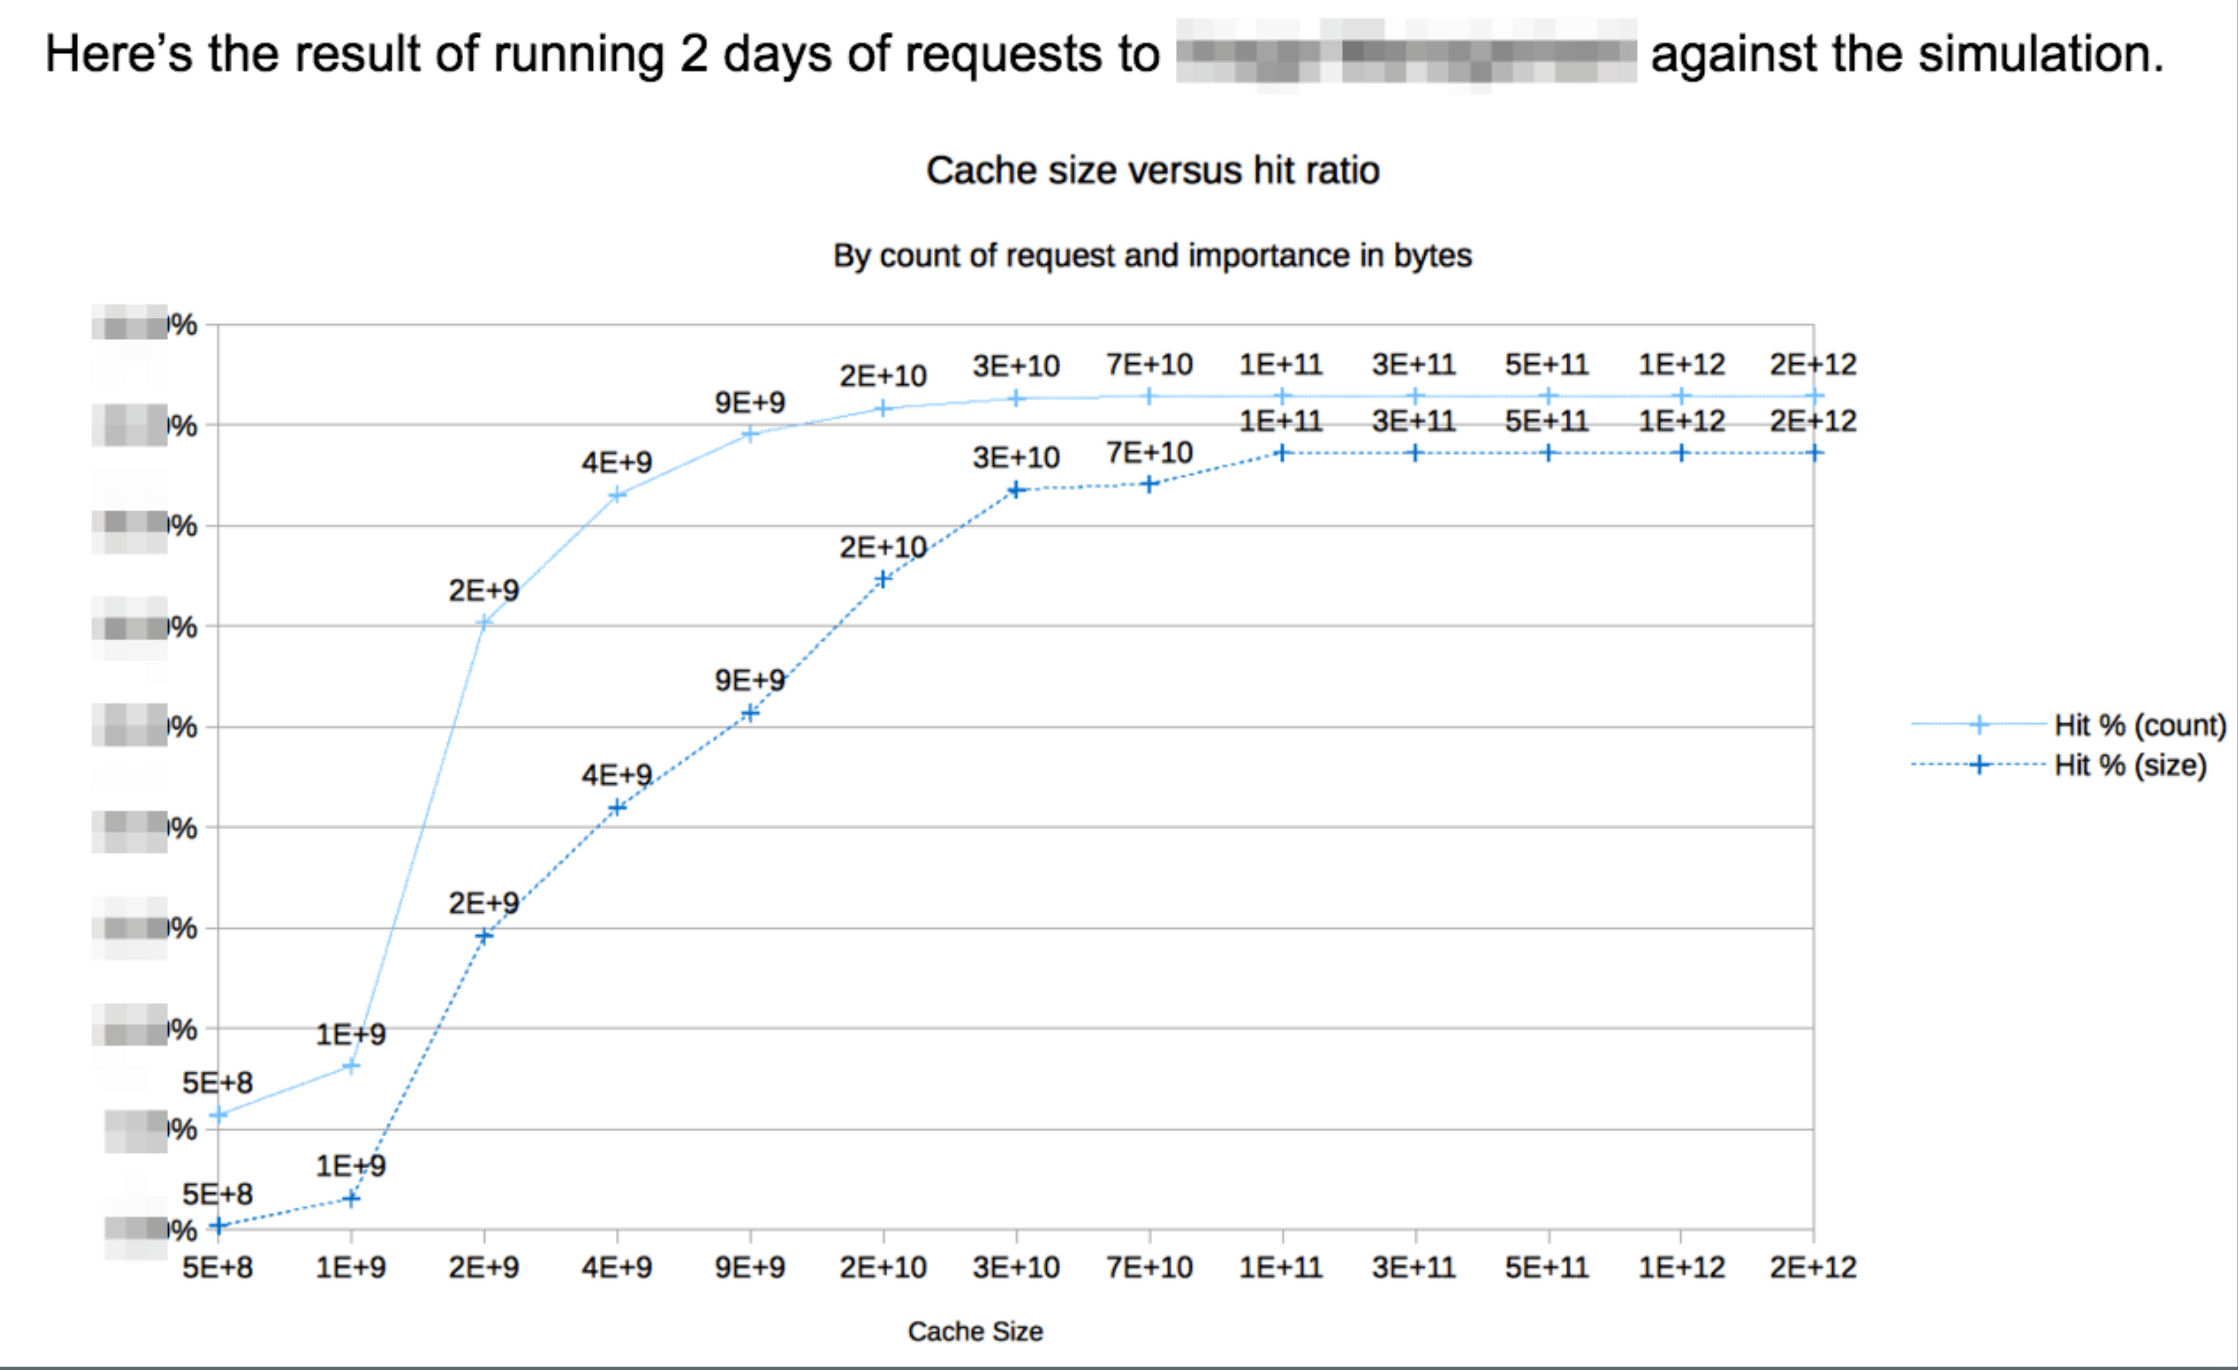
이제 목요일이었다, 나는 이 모든 작업을 48시간 동안 미친 듯이 몰아친 코딩으로 해냈다. 나는 내 논거를 RFC로 써서, 다른 사람들이 읽고 검토하도록 Slack에 던져 놓고 월요일까지 잤다.
마음이 녹다
그래서 나의 월요일, 노트북을 다시 열었을 때, blobcache는 승인되어 있었다. 나는 또한 이미 그 대부분을 구현해 두었다.
그래서 blobcache의 설계와 함께, 과거에 blobcache가 있었다면 우리가 무엇을 얻었을지 보여 주는 시뮬레이션이 나갔다. 이건 그냥 "날 믿어, 아마 괜찮을 거야"가 아니라, "우리에게 그게 있었다면, 이렇게 설득력 있게 예측 가능한 방식으로 우리를 도왔을 것이고, 이렇게 동작했을 것이다"였다. 이것은 몇몇 하이퍼바이저에서 시험 운영을 정당화했고, 백엔드 코드가 캐시의 디스크 사용과 존재 때문에 절망에 빠져 뒤집어지지 않는다는 것을 증명한 뒤에 (디스크 공간을 캐싱에 쓰면 스케줄링 목적의 알 수 없는 사용량 집계가 깨질 수 있다는 걱정이 있었다), 하이퍼바이저군 전체로 롤아웃되었다.
그것은 그 뒤로 길고도 여러 해 동안 높은 히트율의 행복한 삶을 살며 흔한 디스크 이미지에 대한 Droplet의 높은 회전율을 흡수했다. 내가 아는 한, 내가 떠나고 몇 년 뒤에도 여전히 돌아가고 있었다.
그다음에 온 것
이것이 내가 그곳에서 한 마지막 모델링과 시뮬레이션은 아니었다. 이미지 관리의 성공에 힘입어, Nick, Justin, 그리고 나는 Droplet이 아닌 첫 새로운 DigitalOcean 제품을 도입하는 일로 넘어갔다: Volumes (네트워크 연결 블록 스토리지). 여기에는 더 다른 종류의 시뮬레이션들이 필요했다 - 유량 네트워크.
blobcache로 말하자면, Volumes 이후까지 손대지 않은 채 그대로 두었다. 나는 가십 방식의 P2P를 하고 블롭을 머클 트리를 써서 고정 크기 청크로 나누는 - 비트토렌트 방식 - v2 작업을 잠시 재개했다가, v1이 대체로 충분히 좋았고 새 일이 보드에 올라와 있었기 때문에 개발 도중에 포기했다. 달콤 씁쓸했지만, 나는 쿠버네티스 제품으로 탈바꿈한 컨테이너 런타임 서비스의 프로토타입 작업을 시작할 기회를 얻었다, DigitalOcean에서의 내 근무의 정점; IPO로 가는 길에서의 DOKS 출시.